
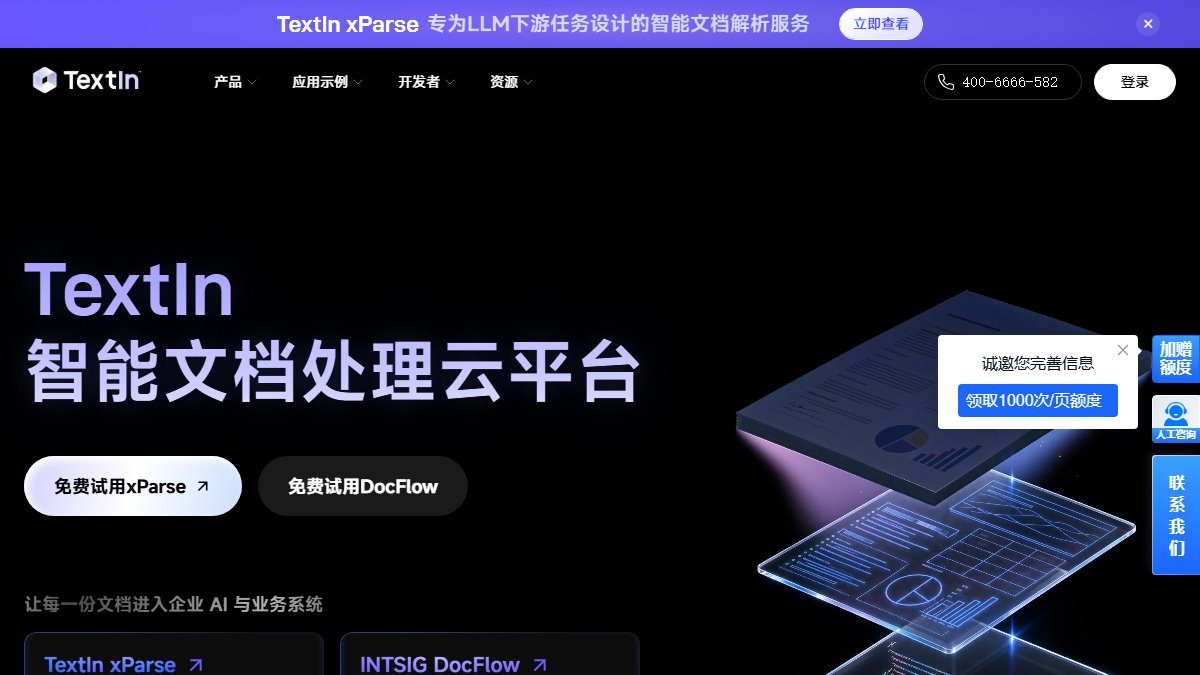
01TextIn 是什么
TextIn 干的是「把纸变成数据」这件事:扫描件、PDF、表格、公式、手写体,解析成结构化文本和字段。
它背后是合合信息的 OCR 积累(扫描全能王那家),对中文排版的还原度在国产里算靠前。
短板是场景边界。复杂表格和跨页内容仍会错行,公式识别对小众符号支持一般;免费额度按页算,很快用完。
02TextIn 能做什么
文档解析
PDF 和扫描件。
表格识别
还原结构。
公式识别
转 LaTeX。
手写体 OCR
常见场景。
API 接入
批量处理。
03怎么开始用 TextIn
- 先小批量试准确率再放量。
- 扫描件保证分辨率300dpi 起。
- 表格类单独走接口通用解析会丢列。
- 结果人工抽检认错字很常见。
04识别准确率的三个变量
第二个最常被忽略。
| 变量 | 影响 |
|---|---|
| 扫描分辨率 | 低于 300dpi 明显掉 |
| 版式复杂度 | 多栏和表格最难 |
| 字体和语种 | 生僻字会错 |
| 图片倾斜 | 先纠偏再识别 |
05好在哪,差在哪
中文版式还原好
国产优势。
能力分得细
按场景选接口。
有免费额度
可以先试。
用得上
- 票据和合同批量识别
- 表格转结构化数据
- 论文公式转 LaTeX
- 档案电子化项目
别指望
- 手写潦草的识别
- 复杂跨页表格
- 免费大量处理
- 完全没有人工校验的流程
06价格和套餐
| 版本 | 价格 | 说明 |
|---|---|---|
| 免费额度 | 免费 | 按页数算。 |
| 按量计费 | 按页 | 不同接口单价不同。 |
| 企业版 | 面议 | 私有化和包量。 |
免费额度按页计量,正式用按页付费。复杂表格和跨页内容仍要人工校对。
07谁适合用
财务票据录入
批量识别。
合同数字化
条款抽取。
论文公式识别
转 LaTeX。
档案电子化
老文件处理。
08官网入口
官网 textin.com,国内可直接访问。文档内容可能含敏感信息,上传前确认条款。
09同类工具



10常见问题
TextIn 是什么?
合合信息的文档处理平台,把 PDF 和扫描件解析成结构化数据,还能识别表格和公式。
和百度 OCR 怎么选?
要中文复杂版式和公式识别看 TextIn,要通用 OCR 和生态集成看百度。
免费吗?
有免费额度,按页计量。
表格能还原吗?
简单表格可以,复杂跨页的会错行。