
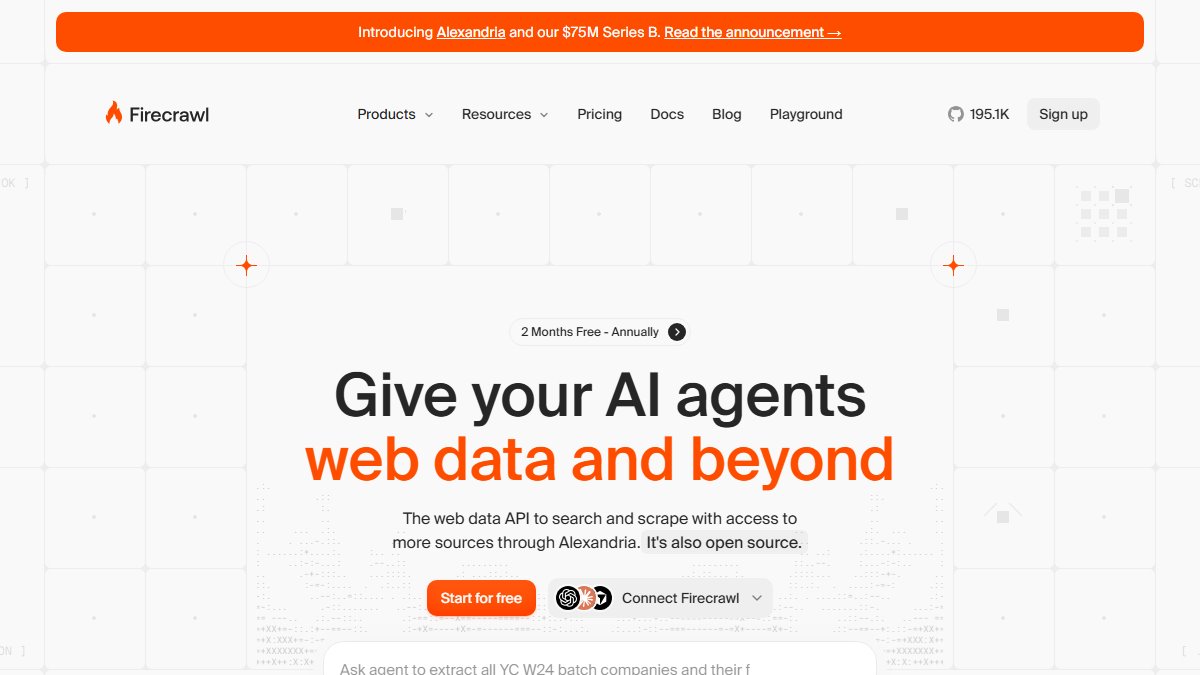
01Firecrawl 是什么
Firecrawl 干一件事:给一个网址,返回这个页面(或整站)的干净 Markdown,正文留下、广告和导航去掉。
它专为喂模型设计——处理动态渲染页面、自动翻页、输出结构化数据,比自己写解析规则省事得多。
短板是价格和稳定性。按页计费,整站爬取很快就贵了;有些站点会挡,成功率不是 100%。
02Firecrawl 能做什么
单页转 Markdown
正文提取。
整站爬取
按目录遍历。
动态页面
能渲染 JS。
结构化提取
按 schema 输出。
批量接口
多 URL 一起。
03怎么开始用 Firecrawl
- 先单页测效果看正文提得干不干净。
- 限制爬取深度整站很容易过量。
- 加缓存别重复爬。
- 用 schema 提字段比自己解析稳。
04抓一页和一整站的区别
整站要限制深度,否则费用失控。
POST https://api.firecrawl.dev/v1/scrape
{ "url": "https://example.com/post", "formats": ["markdown"] }

# 整站:加 crawl 接口和 limit
{ "url": "https://example.com", "limit": 50 }
先 scrape 单页看正文提得干不干净,再上 crawl。带登录态或强反爬的站点成功率明显下降。
05好在哪,差在哪
输出直接能喂模型
省一步清洗。
动态页面能处理
普通爬虫做不到。
接口简单
一个 POST。
用得上
- RAG 建知识库
- 整站转 Markdown
- 动态页面抓取
- 结构化字段提取
别指望
- 要绝对稳定抓取
- 零成本整站爬
- 需登录内容
- 实时高频调用
06价格和套餐
| 版本 | 价格 | 说明 |
|---|---|---|
| 免费额度 | 免费 | 每月少量页数。 |
| 付费档 | 按页计费 | 量大单价降。 |
| 企业版 | 面议 | 并发和支持。 |
按页计费,整站爬取成本上得快。被目标站拦截的情况要预留失败率。
07谁适合用
RAG 建库
批量抓文档。
内容迁移
整站转 Markdown。
竞品监控
定时抓页面。
数据清洗
提取结构化字段。
08官网入口
官方域名 firecrawl.dev,国内访问需要网络条件。抓取前遵守目标站的 robots 和条款。
09同类工具


10常见问题
Firecrawl 是什么?
网页抓取并转成 Markdown 的接口,专为喂给大模型设计。
和普通爬虫怎么选?
要干净正文和动态页面处理选 Firecrawl,要完全可控选自己写。
怎么收费?
按页计费,有免费额度。
抓取成功率如何?
大部分站可以,但有些会拦截,要预留失败率。